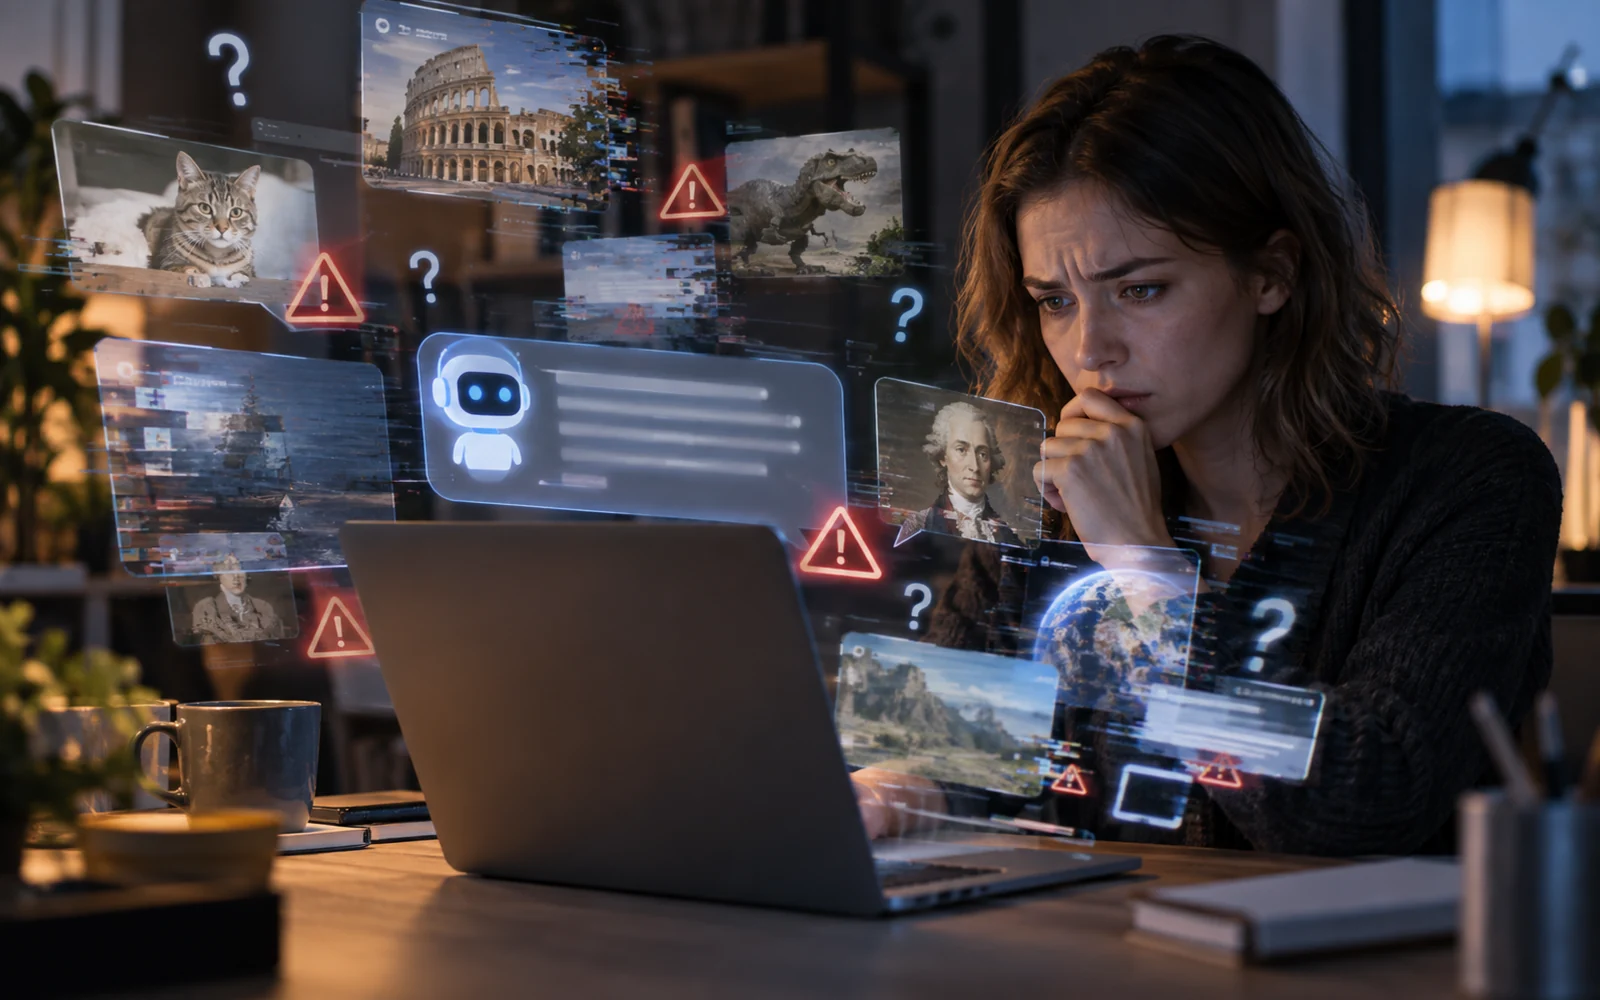
Požiadate chatbota o názov vedeckej štúdie a on bez zaváhania uvedie autorov, rok aj odkaz. Po kliknutí sa ukáže, že článok neexistuje. Inokedy vytvorí presvedčivý životopis, pomýli si zákony alebo pripíše známemu človeku výrok, ktorý nikdy nepovedal. Hladká formulácia odpovede je preto slabým dôkazom jej pravdivosti.
AI si dokáže vymyslieť fakty, pretože jazykový model vytvára pravdepodobný text, nie automaticky overený opis reality. Takéto chyby sa nazývajú halucinácie a môžu zahŕňať neexistujúce zdroje, nesprávne dátumy aj presvedčivé, no nepravdivé vysvetlenia. Riziko znížite konkrétnym zadaním, prácou so skutočnými podkladmi a kontrolou dôležitých tvrdení v nezávislých zdrojoch. Ani vyhľadávanie či citácie nie sú neomylnou zárukou.
Znamená to, že AI úmyselne klame?
Bežný jazykový model nemá dôvod chápať ako človeka s vedomým zámerom podviesť. Keď vygeneruje nesprávny údaj, presnejší opis je, že vytvoril nepravdivú odpoveď alebo halucináciu. V bežnej reči sa hovorí, že „klame“, ale tento výraz môže nesprávne naznačovať úmysel. Pri hodnotení výsledku je dôležitejšie, že ho používateľ nemôže bez overenia považovať za fakt.
Mohlo by vás zaujímať
Chybná odpoveď navyše nemusí byť úplne vymyslená. Model môže zlúčiť údaje o dvoch podobných osobách, zameniť rok prijatia zákona s dátumom účinnosti alebo uviesť skutočnú štúdiu ako podporu tvrdenia, ktoré sa v nej nenachádza. Takéto kombinované chyby sa odhaľujú ťažšie než očividná hlúposť.
Ako halucinácie vznikajú
Jazykové modely sa počas tréningu učia vzory v rozsiahlych textových dátach. V jednoduchom opise ide o odhadovanie ďalších častí textu na základe kontextu. Tento proces im umožňuje tvoriť výborné vysvetlenia, preklady aj pracovné návrhy, no sám osebe nevybuduje spoľahlivý register overených faktov. Predikcia jazykovo presvedčivej odpovede sa líši od dôkazu, že odpoveď sedí.
Výskumná práca OpenAI o halucináciách upozorňuje aj na problém hodnotenia modelov: systémy môžu získavať lepšie skóre, keď hádajú, než keď priznajú neistotu. V zložitej otázke tak model vyplní medzeru odpoveďou, ktorá znie ako správna. Keď sa nenaučí primerane povedať „neviem“, používateľ dostane falošný pocit istoty.
Vymyslené tvrdenia môžu pochádzať aj z nedostatočného kontextu, nejednoznačného zadania alebo zastaraných informácií. Ak sa opýtate na čerstvé rozhodnutie úradu bez dostupného aktuálneho podkladu, samotná plynulosť odpovede nenahradí prístup k presnému zneniu. A ani dostupný dokument nezaručí, že model správne vyloží jeho výnimky či prechodné ustanovenia.
Najtypickejšie chyby, ktoré vyzerajú dôveryhodne
Fiktívna bibliografia je častý príklad. Model vytvorí realistický názov štúdie, priradí skutočne existujúceho vedca a doplní nepravdivý identifikátor. Výsledok môže na prvý pohľad vyzerať lepšie než článok bez zdrojov. Kontrola však znamená skutočne otvoriť citovanú publikáciu a overiť, či vôbec existuje a podporuje konkrétny výrok.
Ďalšou chybou sú čísla bez kontextu. Model môže tvrdiť, že výrobok má určitý výkon, krajina prijala pravidlo v presnom roku alebo služba stojí konkrétnu sumu. Ak údaje nemá z overeného aktuálneho cenníka či dokumentácie, presnosť na dve desatinné miesta nie je dôvodom veriť výsledku. Pozornosť si zaslúžia aj generované citácie zákonov s nesprávnym paragrafom.
Zavádzajúce môžu byť dokonca aj odpovede, v ktorých sú jednotlivé fakty správne. Model ich môže pospájať do nesprávneho záveru, vynechať podstatnú výnimku alebo pomiešať pravidlá dvoch krajín. Pri zdravotných, právnych či finančných témach preto nestačí kontrolovať jedno číslo: treba preveriť logiku a platnosť odporúčania pre konkrétny prípad.
Pomôže, keď požiadate o zdroje?
Áno, zdroje sú užitočné, ale len ak ich reálne otvoríte. Požiadavka „pridaj odkazy“ môže zlepšiť transparentnosť, no model môže vygenerovať aj neexistujúce URL alebo použiť pravý odkaz na nesprávne tvrdenie. Lepší postup je pracovať s konkrétnymi dokumentmi, presnými názvami a dátumami, ktoré možno nezávisle skontrolovať.
IBM opisuje metódu RAG, pri ktorej systém najprv vyhľadá informácie v zvolenom zdroji a potom na ich základe odpovedá. Takéto ukotvenie môže halucinácie obmedziť, ale nevylúči ich: vyhľadávanie môže priniesť nesprávny dokument, stránka môže byť zastaraná a model môže text zle pochopiť. „Má prístup na internet“ preto nie je ekvivalent „všetko overil“.
Pri pracovnej úlohe sa oplatí výslovne určiť, čo je povolený zdroj a čo sa má stať, keď informácia chýba. Napríklad požiadavka „odpovedaj len z priloženého cenníka, pri nejasnosti napíš, že údaj nie je uvedený“ je lepšia než všeobecné „napíš mi správnu cenu“. Aj tak zostáva kontrola na človeku, ktorý výsledok publikuje alebo používa pri rozhodovaní.
Ako si odpoveď prakticky preveriť
Najprv rozdeľte odpoveď na konkrétne tvrdenia. Mená, dátumy, ceny, zákonné povinnosti a štatistiky sú ľahšie overiteľné než všeobecné formulácie. Pri každom dôležitom bode hľadajte pôvodný dokument: rozhodnutie úradu, technickú dokumentáciu výrobcu, vedeckú štúdiu či aktuálne obchodné podmienky. Sekundárny článok môže pomôcť s orientáciou, no pri spornom detaile uprednostnite primárny zdroj.
Skontrolujte tiež čas. Správna informácia z minulého roka nemusí platiť pri dnešnom produkte alebo novelizovanom zákone. Pri údajoch z iných krajín sa pýtajte na jurisdikciu a pri vedeckých záveroch na to, či ide o jednu štúdiu alebo potvrdený širší súbor dôkazov. Nesnažte sa model presvedčiť, že vami želaný záver je pravdivý: môže sa vám prispôsobiť a vytvoriť falošné potvrdenie.
Ak sa odpoveď opakovane mení pri miernej úprave otázky, je to dôvod na zvýšenú opatrnosť. Naopak opakovaná rovnaká odpoveď nie je dôkaz – model môže konzistentne opakovať tú istú chybu. Rozhodujú nezávislé dôkazy, nie sebavedomý štýl ani počet pokusov.
Kedy možno AI používať aj bez rozsiahleho overovania
Pri návrhu štruktúry textu, generovaní nápadov alebo jazykovej úprave vlastného odseku býva riziko menšie, pokiaľ model nepridáva nové fakty. Iná situácia nastáva pri publikovaní zdravotného odporúčania, účtovného postupu alebo konkrétnej právnej rady. Tam by mal výsledok prejsť človekom s relevantnou odbornosťou a kontrolou zdrojov.
Zdravý návyk nie je úplne sa AI vyhýbať, ale rozlišovať tvorivú pomôcku od autoritatívneho zdroja. Model môže urýchliť prípravu a upozorniť na otázky, ktoré by vám nenapadli. Za pravdivosť a dôsledky verejne zverejneného tvrdenia však nezodpovedá pekne formulovaná veta, ale ten, kto ju použije.
Zdroje
- OpenAI – Prečo jazykové modely halucinujú (výskumné vysvetlenie a problém odmeňovania hádania) – https://openai.com/sk-SK/index/why-language-models-hallucinate/
- IBM – What Are AI Hallucinations? (typy chýb a možnosti obmedzenia) – https://www.ibm.com/think/topics/ai-hallucinations
- IBM – What is RAG (Retrieval Augmented Generation)? (práca s podkladmi a jej limity) – https://www.ibm.com/think/topics/retrieval-augmented-generation
Gabriel Čatár
Zaujímajú ma veci, s ktorými sa stretávame každý deň, no často nevieme, ako vlastne fungujú. Od technológií a financií cez praktické návody až po zaujímavosti zo sveta. Na Pitchovinách sa venujem témam, pri ktorých sa oplatí ísť trochu viac do hĺbky, overiť si fakty a vysvetliť ich jednoduchým spôsobom. Mojím cieľom je, aby si čitateľ z každého článku odniesol niečo užitočné.